Scrapy源码学习(一) 一、start_requests方法 start_requests方法是启动爬虫时自动调用的方法,我们可以对其进改改写,比如让它变成post请求,并改变它的回调函数。 二、make_req... 6 年前 Scrapy 2 分钟阅读 9 浏览
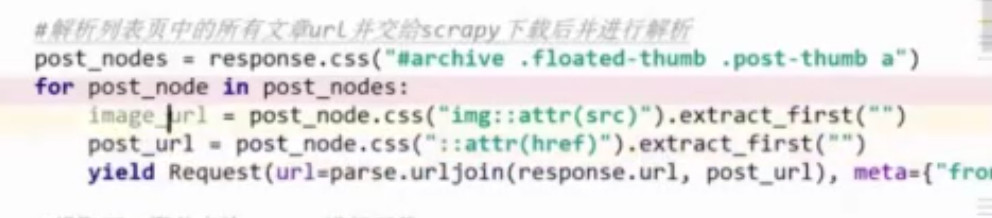
Scrpy的第八个爬虫慕课网(下载图片) 一、抓取jobbole网站 1.scrapy调试 在项目根目录自己写一个main.py,调用命令行。 from scrapy.cmdline import execute import sys import os sys.p... 7 年前 Scrapy 3 分钟阅读 11 浏览
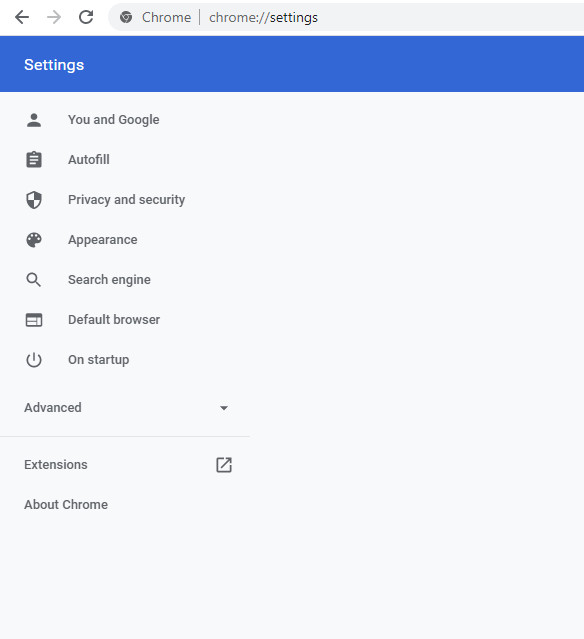
Requests与Xpath搭配(教程) 一、xpath教程 xpath是谷歌浏览器插件。 1.安装 在chrome浏览器打开settings,然后点击“Extensions”,搜索“xpath”即可以找到。 2.查找路径 其实可以使用浏览... 7 年前 Scrapy 2 分钟阅读 7 浏览
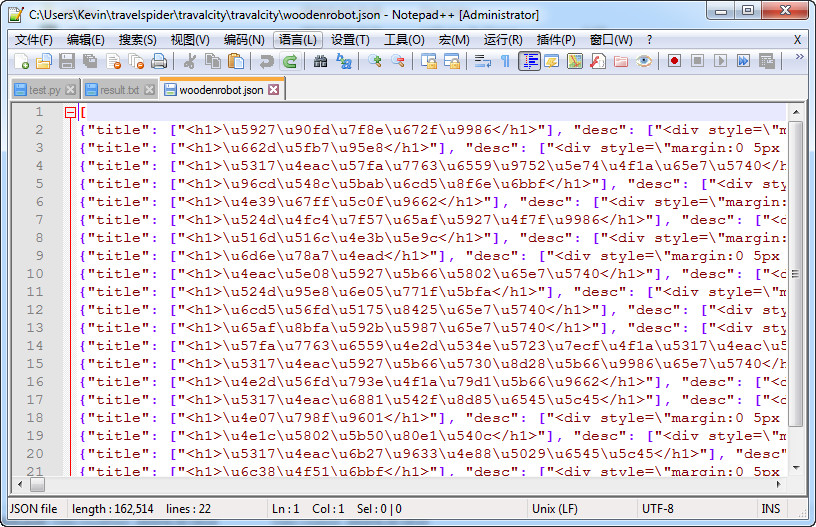
Scrpy的第七个爬虫Travelcity(调试及异步写入SQLite) 一、知识点: 1.urljoin response.urljoin():将相对网址拼接成绝对网址。 比如: url = response.body_as_unicode() url = response.urljoin(url) 这样... 7 年前 Scrapy 8 分钟阅读 7 浏览
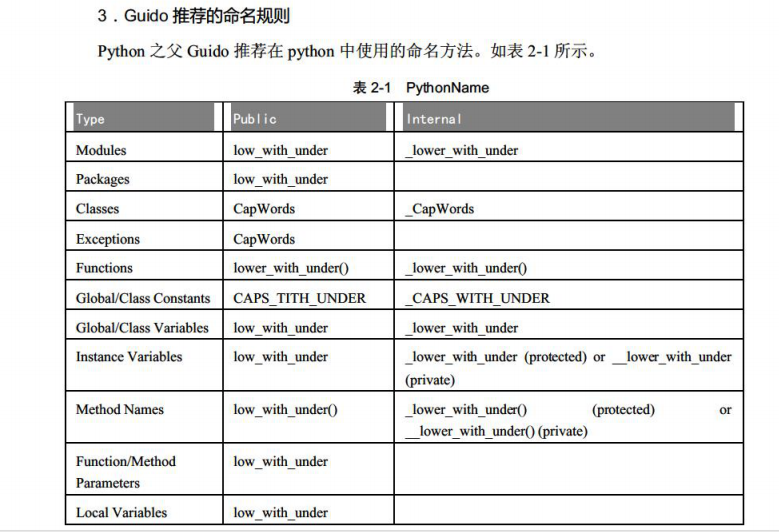
《Python网络爬虫实战》笔记(Xpath) 一、Python命名规则 二、xpath用法: 这里的下标是从1开始的,不是0 抓取图片: 小技巧: 如果遇到]怎么办? links = dom_tree.xpath("//a[... 7 年前 Scrapy 12 分钟阅读 6 浏览
fiddler教程(fiddler可以用来做什么) fiddler的操作非常简单,即开即用型,这里简单备注一下吧。 一、打开浏览器 二、清空原始数据 点击图标上的那个“X”,然后执行“remove all”功能。 三、访问... 8 年前 Scrapy 2 分钟阅读 6 浏览
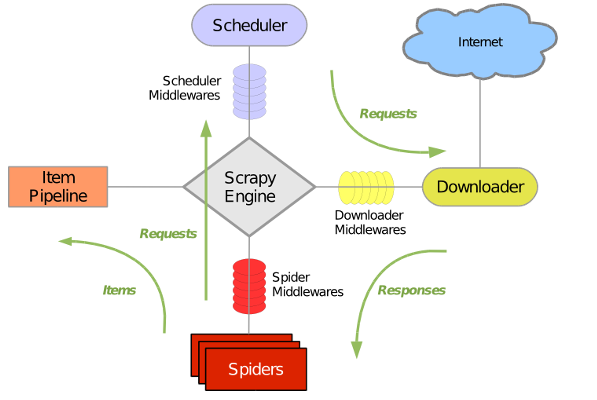
Scrpy的第六个爬虫(爬取腾讯招聘) 学习要点: 1、url拼接 2、通过xpath helper获得xpath路径 3、学习爬虫的整个流程,绿色的箭头代表数据流。 标记一下: 整理文章内文: '/n'.join([p... 9 年前 Scrapy 3 分钟阅读 7 浏览
采集安居客 今天采集https://chengdu.anjuke.com/community/p1/的时候,遭遇了反爬虫。 即使使用scrapy shell https://chengdu.anjuke.com/community/p1/也无法访问。 9 年前 Scrapy 2 分钟阅读 9 浏览
Scrpy的第五个爬虫(爬取详细页面写入SQLite) 学习目标: 掌握采集时翻页功能的实现。 掌握采集详细页面内容的方法 掌握运用Navicat可视化界面建立Sqlite数据库、数据表的方法。 掌握运用Scrapy从建立爬... 9 年前 Scrapy 7 分钟阅读 11 浏览